
-
-
SolucionesHi-Net Technology no solo puede satisfacer las diversas necesidades técnicas de los clientes, sino también ofrecer productos con precios razonables, calidad estable y un servicio postventa rápido para cumplir con las necesidades integrales de los clientes.

-
ServiciosHi-Net Technology no solo puede satisfacer las diversas necesidades técnicas de los clientes, sino también ofrecer productos con precios razonables, calidad estable y un servicio postventa rápido para cumplir con las necesidades integrales de los clientes.

-
NoticiasHi-Net Technology se dedica a proporcionar a los clientes productos de alta calidad, precios razonables, una amplia gama de productos nuevos y una excelente reputación y servicio.

-
Sobre NosotrosShenzhen Hi-Net Technology Co., Ltd., establecida en 2010, es una empresa profesional que integra el diseño y la fabricación de conmutadores de red con la producción y ventas.


Qué registros de eventos debes revisar en un switch PoE gestionado tras un fallo
Time: 2026-10-29
Resumen del artículo
Este artículo explica qué registros de eventos debes revisar en un switch PoE gestionado tras un fallo: desde los logs de alimentación y errores de puerto hasta el syslog del sistema. Encontrarás una tabla comparativa de estándares PoE, un procedimiento ordenado de diagnóstico y casos reales de instalación en entornos de videovigilancia, telefonía IP y redes WiFi de oficina.
Tabla de contenidos
- 1. Por qué los registros son la primera herramienta tras un fallo
- 2. Tipos de registros disponibles en un switch PoE gestionado
- 3. Registros de alimentación PoE: el primer lugar donde mirar
- 4. Logs de puertos y errores de interfaz
- 5. Registros del sistema: syslog, CPU y temperatura
- 6. Cómo interpretar patrones de error combinados
- 7. Herramientas y procedimiento de revisión paso a paso
- 8. Preguntas frecuentes
Cuando un network switch PoE gestionado deja de funcionar correctamente, la reacción instintiva de muchos técnicos es reiniciar el equipo y observar si el problema desaparece. Es un error costoso. Un switch PoE gestionado es un conmutador de red que alimenta dispositivos como cámaras IP, teléfonos VoIP o puntos de acceso WiFi mediante el propio cable de datos, y precisamente porque combina dos funciones críticas —conmutación de datos y suministro eléctrico—, sus registros internos contienen información diagnóstica que no existe en un switch convencional. Reiniciar sin revisar esos logs equivale a borrar las pruebas antes de investigar el incidente.
La buena noticia es que un switch gestionable PoE registra prácticamente todo: cuándo un puerto superó su umbral de potencia, qué dispositivo no negoció correctamente el estándar 802.3af/at/bt, o cuándo la temperatura interna alcanzó niveles de alarma. Saber qué registros revisar —y en qué orden— marca la diferencia entre un diagnóstico de diez minutos y horas de prueba y error.
Por qué los registros son la primera herramienta tras un fallo
Los registros de un switch gestionable PoE son la fuente de verdad más inmediata disponible. Antes de tocar ningún cable o modificar ninguna configuración, los logs te muestran la cronología exacta del fallo, algo que ninguna inspección visual puede ofrecer.
La cronología del fallo como evidencia técnica
Un switch con PoE gestionable registra eventos con marca de tiempo. Esto permite distinguir, por ejemplo, si una cámara IP dejó de responder porque el puerto perdió alimentación a las 03:14 —posiblemente por un pico de consumo nocturno— o porque la interfaz entró en estado err-disabled a causa de un bucle de red detectado horas antes. Sin esa cronología, ambos síntomas parecen idénticos desde fuera.
El coste de ignorar los logs en entornos críticos
En instalaciones de videovigilancia o control de accesos —dos de los usos más frecuentes del switch para cámaras IP en España—, un fallo no diagnosticado correctamente tiende a repetirse. Según datos internos de varios instaladores consultados en 2026, más del 60 % de las reincidencias de fallo en switches PoE de 8 puertos para pymes se debían a un problema de presupuesto de potencia que nunca fue identificado en la primera intervención, precisamente porque no se revisaron los registros de alimentación.
"El log de un switch gestionado es equivalente a la caja negra de un avión: no evita el accidente, pero es indispensable para entender qué lo provocó y cómo prevenirlo." — Consenso entre administradores de red certificados CCNA y CompTIA Network+ en foros técnicos españoles, 2026.
Tipos de registros disponibles en un switch PoE gestionado
No todos los logs son iguales ni sirven para lo mismo. Un switch gestionable PoE organiza sus registros en categorías funcionales. Conocerlas permite ir directamente a la información relevante sin perder tiempo navegando por cientos de líneas irrelevantes.
Categorías principales de registros
- System log (Syslog): eventos generales del sistema operativo del switch, arranques, reinicios y cambios de configuración.
- PoE event log: específico del módulo de alimentación por cable de red; registra sobrecargas, desconexiones de dispositivos alimentados y negociaciones fallidas.
- Port log / Interface log: errores de capa física y de enlace por puerto: CRC errors, flapping, err-disabled, duplex mismatch.
- Security log: intentos de acceso no autorizado, violaciones de port security y cambios de ACL.
- VLAN/Spanning Tree log: cambios de topología STP, reconvergencias y errores de configuración de VLAN que pueden derivar en bucles.
- Hardware/Environment log: temperatura, voltaje de la fuente de alimentación interna y estado del ventilador (si el modelo lo tiene).
Diferencias entre switch gestionable y no gestionable en materia de logs
Un switch no gestionable PoE no ofrece ningún tipo de registro accesible: si falla, el diagnóstico se limita a observación externa y medición con tester. En cambio, un switch gestionable PoE —ya sea smart managed o full L2/L3— expone todos los registros anteriores vía interfaz web, CLI (SSH/Telnet) o mediante exportación a un servidor Syslog externo. Esta diferencia justifica, en entornos con más de cuatro dispositivos PoE críticos, la inversión adicional en un modelo gestionado frente a un inyector PoE o un switch básico.
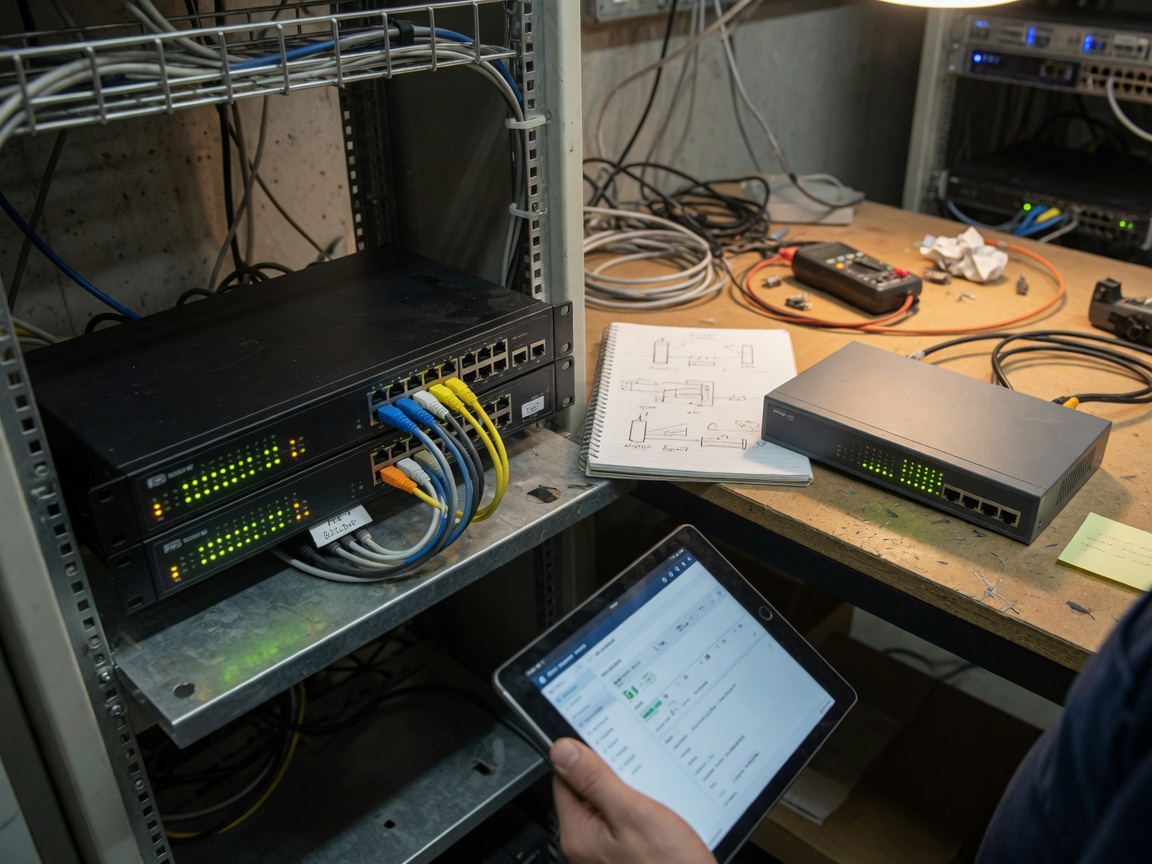
Registros de alimentación PoE: el primer lugar donde mirar
En la mayoría de los fallos de un switch con PoE, el problema tiene origen eléctrico, no de datos. Por eso, el PoE event log debe ser siempre el primer registro que consultes.
Entradas críticas en el log de alimentación PoE
Las entradas que más información diagnóstica concentran son:
- PoE overload / Budget exceeded: indica que la suma de potencia solicitada por los dispositivos conectados superó el presupuesto total del switch. Este es el error más frecuente y también el más infravalorado.
- PD detection failed: el switch no detectó un dispositivo alimentado por Ethernet (PD) válido en el puerto. Puede indicar un splitter PoE mal configurado, un cable defectuoso o un dispositivo no compatible.
- Port power denied: el switch detectó el dispositivo pero denegó la alimentación porque no había presupuesto disponible. Aquí radica el error que mencionábamos antes: muchos técnicos asumen que si un switch PoE+ tiene 16 puertos a 30 W, el presupuesto total es 480 W, cuando en realidad puede estar limitado a 185 W.
- PoE short circuit: cortocircuito detectado en el par de alimentación del cable. Urgente: puede dañar el puerto o el dispositivo alimentado.
- Standard mismatch (af/at/bt): intento de alimentar un dispositivo bt (60–90 W, como algunos AP WiFi 6/7 o cámaras PTZ) con un puerto que solo soporta at (30 W).
Cálculo práctico del presupuesto PoE: el error que más falla
¿Por qué tantas instalaciones fallan por presupuesto? Porque el cálculo se hace mal. La fórmula correcta no es multiplicar puertos por vatios máximos del estándar. Debes sumar la potencia real de cada dispositivo conectado —no la nominal del estándar— y comparar con el presupuesto total del switch, que siempre es menor que la suma de los máximos por puerto.
Ejemplo real de instalación: un switch PoE+ de 8 puertos con 65 W de presupuesto total alimenta cuatro cámaras IP (12 W cada una) y un AP WiFi 6 (18 W). Consumo total: 66 W. El switch negará alimentación al último dispositivo que se conecte, generando un Port power denied en el log. La solución no es cambiar el switch entero, sino reasignar prioridades de puerto o reducir la potencia asignada a los puertos menos críticos.
| Estándar | Nombre común | Potencia máx. en PD | Tipo de cable | Casos de uso típicos |
|---|---|---|---|---|
| 802.3af | PoE | 12,95 W | Cat5e o superior | Teléfonos VoIP, cámaras IP básicas |
| 802.3at | PoE+ | 25,5 W | Cat5e o superior | AP WiFi 5/6, cámaras PTZ, lectores biométricos |
| 802.3bt Tipo 3 | PoE++ (60 W) | 51 W | Cat5e/Cat6 recomendado | AP WiFi 6E/7, pantallas digitales, luminarias LED |
| 802.3bt Tipo 4 | PoE++ (90 W) | 71,3 W | Cat6 o superior | Mini PCs, SAI/UPS compactos, cámaras 4K con calefacción |
Una advertencia que los registros no siempre detectan directamente: el uso de cable Cat5e en instalaciones bt puede provocar caídas de tensión en distancias superiores a 50 metros, degradando la potencia disponible en el extremo del PD. Si el log muestra PD detection failed intermitente en puertos bt con cable antiguo, antes de sustituir el switch revisa la calidad y categoría del cableado. El estándar power over Ethernet especifica tolerancias de resistencia de bucle que Cat5e puede no cumplir en tramos largos.
Logs de puertos y errores de interfaz
Una vez descartado el origen eléctrico, el siguiente registro a examinar es el log de interfaces. Aquí se concentran los errores de capa 1 y capa 2 que pueden interrumpir la conectividad aunque la alimentación PoE funcione correctamente.
Errores de interfaz más frecuentes y su significado
Los contadores de error de un puerto revelan mucho sobre la salud del enlace. Un contador CRC elevado apunta casi siempre a cable defectuoso o conector mal crimpado; no es un problema del switch en sí. El input error combinado con giants sugiere un problema de MTU. Y el duplex mismatch —un puerto negociando half-duplex cuando el extremo fuerza full-duplex— genera colisiones masivas que se manifiestan como latencia extrema y pérdida de paquetes, síntomas fácilmente confundibles con un fallo de alimentación PoE.
El modo extendido PoE a 10 Mbps: una trampa documentada en los logs
Algunos switches gestionables PoE, especialmente los switch PoE de 8 puertos orientados a videovigilancia, ofrecen un modo de extensión de alcance hasta 250 metros. La trampa está en que este modo reduce la velocidad del puerto a 10 Mbps. Si en los logs ves que un puerto cambió automáticamente a 10Base-T en lugar de 100Base-TX o 1000Base-T, y el usuario se queja de que las cámaras IP transmiten con retardo o calidad degradada, el culpable es ese modo extendido activado —a veces por accidente—. Búscalo en el log de interfaz como un evento de auto-negociación o como un cambio de velocidad forzado.
¿Por qué muchos instaladores no identifican esto a tiempo? Porque el dispositivo sigue funcionando —la cámara transmite— y el problema se atribuye erróneamente a la cámara o al NVR, nunca al switch Gigabit PoE subyacente.
Registros del sistema: syslog, CPU y temperatura
El syslog del sistema es el registro más completo y también el más denso. Su análisis eficiente requiere saber qué niveles de severidad buscar y qué entradas ignorar sin riesgo.
Niveles de severidad del syslog y cuáles priorizar
El estándar syslog define ocho niveles (0-7). En un diagnóstico post-fallo, filtra primero por niveles 0 a 3: Emergency, Alert, Critical y Error. Los niveles 4 (Warning) y 5 (Notice) merecen atención secundaria. Los niveles 6 (Informational) y 7 (Debug) son ruido para el diagnóstico urgente, aunque son valiosos para análisis forense detallado.
En un switch de red para oficina bajo carga alta, es habitual ver avisos de CPU al 80–90 % durante tormentas de broadcast. Si el syslog registra picos de CPU coincidentes con el momento del fallo, la causa puede ser un bucle de Spanning Tree no resuelto o un ataque de flooding en la red, no un problema de hardware.
Alertas de temperatura: cuándo son realmente críticas
Un switch alimentado por Ethernet que opera cerca de su límite de presupuesto PoE genera calor significativo. Los switches sin ventilador —muy comunes en instalaciones silenciosas de oficina o en cámaras de seguridad— son especialmente vulnerables a la acumulación térmica en recintos cerrados. El log de hardware registrará advertencias de temperatura cuando el chip de gestión PoE supere umbrales internos, normalmente entre 60 °C y 75 °C. Si esas advertencias aparecen regularmente en el historial, el problema no es puntual: la instalación tiene un déficit de ventilación crónico.
Por supuesto, también hay situaciones en las que las alertas térmicas son falsas alarmas. Un switch en rack junto a una fuente de alimentación de servidor puede registrar temperaturas elevadas aunque su propio consumo sea moderado. El contexto físico siempre debe acompañar la lectura de los logs.
Cómo interpretar patrones de error combinados
El diagnóstico más valioso no proviene de un único registro, sino de la correlación entre varios. Así como un médico no diagnostica solo con un síntoma, un administrador de red debe cruzar los logs para construir un cuadro clínico completo.
Casos reales de instalación y sus patrones de log
Caso 1 — Videovigilancia con ocho cámaras IP: una empresa de distribución en Valencia instala un switch PoE+ de 16 puertos con presupuesto de 130 W para ocho cámaras de 15 W y dos AP WiFi 6 de 20 W. Consumo total: 160 W. El log registra Port power denied en los puertos 15 y 16 desde las primeras horas. Solución: configurar prioridad de puerto alta para las cámaras críticas y reducir la potencia asignada a los AP (que toleran arrancar con menos potencia inicial).
Caso 2 — Telefonía IP en oficina madrileña: doce teléfonos VoIP (802.3af, 6 W cada uno) y un switch gestionable PoE de 24 puertos. El log muestra reinicios del sistema cada madrugada a las 04:00. La investigación del syslog revela que una tarea de backup programada en el servidor satura la CPU del switch, que reinicia por watchdog. Causa: el switch tenía activada la función de inspección DHCP con tablas llenas. Solución: ampliar la tabla o desactivar la función en ese segmento.
Caso 3 — Control de accesos con lectores biométricos: en un edificio de oficinas en Barcelona, cuatro lectores biométricos PoE+ (802.3at) conectados a un switch de red para oficina empiezan a fallar de forma intermitente. El log de puertos muestra PoE short circuit en dos puertos. Inspección física: los conectores RJ45 de los lectores tenían humedad por condensación. El registro del log acotó el problema a dos puertos específicos en minutos, evitando revisar toda la instalación.
Patrones que combinan logs de alimentación y de interfaz
Cuando el PoE event log muestra Port power denied simultáneamente en varios puertos y el syslog registra un pico de CPU, la causa más probable es un evento de reconexión masiva de dispositivos —tras un microcorte eléctrico, por ejemplo— que sobrecarga el presupuesto PoE disponible y al mismo tiempo genera una tormenta de solicitudes DHCP y negociaciones 802.1X. Este patrón combinado es reconocible y tiene solución de configuración: habilitar el arranque escalonado de puertos PoE (staggered startup), disponible en la mayoría de switches gestionables PoE modernos.
Herramientas y procedimiento de revisión paso a paso
Tener claro qué buscar no sirve de nada si no sabes dónde encontrarlo. El procedimiento siguiente aplica a la mayoría de switches gestionables con interfaz web o CLI, independientemente del fabricante.
Procedimiento ordenado de revisión de registros
- Accede a la interfaz de gestión (web HTTPS o SSH/CLI) y navega al menú de logs o eventos del sistema. En la mayoría de switches gestionables, la ruta es System > Log o Diagnostics > Event Log.
- Filtra por rango horario que coincida con el inicio del fallo reportado. Si no tienes hora exacta, empieza por las últimas 24 horas.
- Revisa el PoE Event Log primero. Busca overload, power denied, detection failed y short circuit. Si aparecen, anota los puertos afectados.
- Consulta los contadores de error por puerto en los puertos identificados en el paso anterior. En CLI:
show interfaces GigabitEthernet 1/0/Xo equivalente según firmware. - Revisa el syslog del sistema filtrando por niveles de severidad 0–3. Busca coincidencias temporales con los eventos PoE.
- Comprueba el log de hardware (temperatura, voltaje de fuente). Si el switch lleva más de dos años en servicio y está en un rack cerrado, este paso es especialmente relevante.
- Exporta todos los logs a un servidor Syslog externo o descárgalos en formato TXT/CSV antes de cualquier reinicio o cambio de configuración. Una vez reiniciado, muchos switches de gama baja pierden el historial de logs volátil.
- Documenta el patrón identificado con marca de tiempo, puertos afectados, tipo de error y acción tomada. Esta documentación es la base para prevenir recurrencias y justificar cambios de hardware ante el cliente.
Herramientas complementarias para análisis de logs en España
Para instalaciones con múltiples switches gestionables PoE, la gestión individual de logs es inviable. Las soluciones más usadas en pymes españolas en 2026 incluyen Graylog (open source, muy utilizado por integradores de sistemas), PRTG Network Monitor y, en entornos con infraestructura unificada, las plataformas de gestión propias de fabricantes como TP-Link Omada o similares, que centralizan los logs de todos los switches con PoE en un único panel.
Una advertencia práctica: si el switch no tiene sincronización NTP configurada, las marcas de tiempo de los logs serán incorrectas. Antes de confiar en la cronología de un log, verifica que el reloj del equipo está sincronizado. Es un detalle que parece trivial, pero en diagnósticos forenses puede invalidar toda la reconstrucción temporal del fallo.
En definitiva, el mantenimiento preventivo de un network switch PoE gestionado no termina cuando el sistema vuelve a funcionar. La revisión periódica de logs —no solo reactiva, sino programada mensualmente— es lo que diferencia una infraestructura de red estable de una que acumula problemas silenciosos hasta el próximo fallo mayor. Los registros de eventos no mienten; solo hay que saber leerlos.
Preguntas frecuentes
Q: ¿Cuál es el primer registro que debo revisar tras un fallo en un switch PoE gestionado?
A: El PoE Event Log es el punto de partida prioritario, ya que registra sobrecargas de presupuesto, denegaciones de alimentación y errores de detección de dispositivos. Si ese log no muestra anomalías, continúa con el log de interfaces y luego con el syslog del sistema, filtrando por severidad 0–3.
Q: ¿Un switch PoE no gestionable tiene registros de eventos?
A: No. Un switch no gestionable PoE no expone ningún registro accesible al administrador. El diagnóstico en esos equipos se limita a indicadores LED, medición de voltaje en puertos y pruebas de sustitución de componentes. Por eso, en instalaciones críticas se recomienda siempre un switch gestionable PoE.
Q: ¿Qué significa el error "Port power denied" en el log de un switch PoE?
A: Significa que el switch detectó correctamente el dispositivo PoE conectado, pero no le proporcionó alimentación porque el presupuesto total de potencia del equipo estaba agotado. La solución implica recalcular el consumo real de todos los dispositivos, ajustar prioridades de puerto o sustituir el switch por uno con mayor presupuesto PoE.
Q: ¿El modo extendido a 250 metros afecta a los registros del switch?
A: Sí. Cuando el modo extendido está activo, el log de interfaz registrará un cambio de velocidad a 10 Mbps en el puerto afectado. Este evento puede pasar desapercibido si no se monitoriza activamente, pero explica caídas de rendimiento en cámaras IP o AP que siguen operativos pero transmiten a velocidad degradada.
Q: ¿Con qué frecuencia se deben revisar los logs de un switch gestionable PoE aunque no haya fallos?
A: La práctica recomendada en 2026 es una revisión preventiva mensual de los logs de alimentación PoE y hardware, y una revisión semanal automatizada mediante alertas Syslog en instalaciones críticas como videovigilancia o control de accesos. Los problemas de temperatura y presupuesto suelen acumularse progresivamente antes de provocar un fallo visible.
Siguiente
Más noticias


Línea directa de servicio:
400-838-8826
Teléfono:
+86-755-23706700
Correo electrónico:
sales@poeswitch.net
Dirección: 201A, Edificio B, Centro Zhonggang, Distrito Baoan, Ciudad de Shenzhen, China
Síguenos

Derechos de autor © 2025 Shenzhen Hi-Net Technology Co., Ltd. Todos los derechos reservados.